AI crawler access logs: Serverlogs für KI-Crawler prüfen
Praktischer Leitfaden für SEO-Teams: KI-Crawler in Serverlogs erkennen, Statuscodes prüfen, Frequenz bewerten und blockierte URLs beheben.
TL;DR
TL;DR: Serverlogs zeigen, ob GPTBot, ClaudeBot, PerplexityBot und andere KI-Crawler zentrale URLs erreichen, wie oft sie abrufen und welche Statuscodes sie erhalten. Priorität haben verifizierte User-Agents, 200er-Zugriffe auf wichtige Seiten, saubere robots.txt-Regeln und schnelle Korrekturen bei 403, 404, 5xx oder fehlenden Hits.
AI crawler access logs sind 2026 ein operatives SEO-Signal, weil KI-Suchsysteme Inhalte nicht nur ranken, sondern auch für Antworten, Zusammenfassungen und Quellenbewertung abrufen. Ein Webcrawler ist ein Internet-Bot, der Webseiten systematisch besucht; ein KI-Crawler erfüllt diese Aufgabe für Systeme wie Chatbots, Antwortmaschinen oder Trainings- und Retrieval-Pipelines. Indexerhub hilft Teams, Indexierungs- und Sichtbarkeitsprozesse enger mit solchen Zugriffsdaten zu verbinden.
Table of ContentsWas zeigen AI crawler access logs wirklich?
AI crawler access logs zeigen, welche KI-bezogenen Bots welche URLs abrufen, welchen HTTP-Status sie erhalten und ob wichtige Inhalte technisch erreichbar sind. Für große Websites ist das zuverlässiger als reine Analytics-Daten, weil viele Bot-Zugriffe kein JavaScript ausführen und deshalb in klassischen Tracking-Tools fehlen.
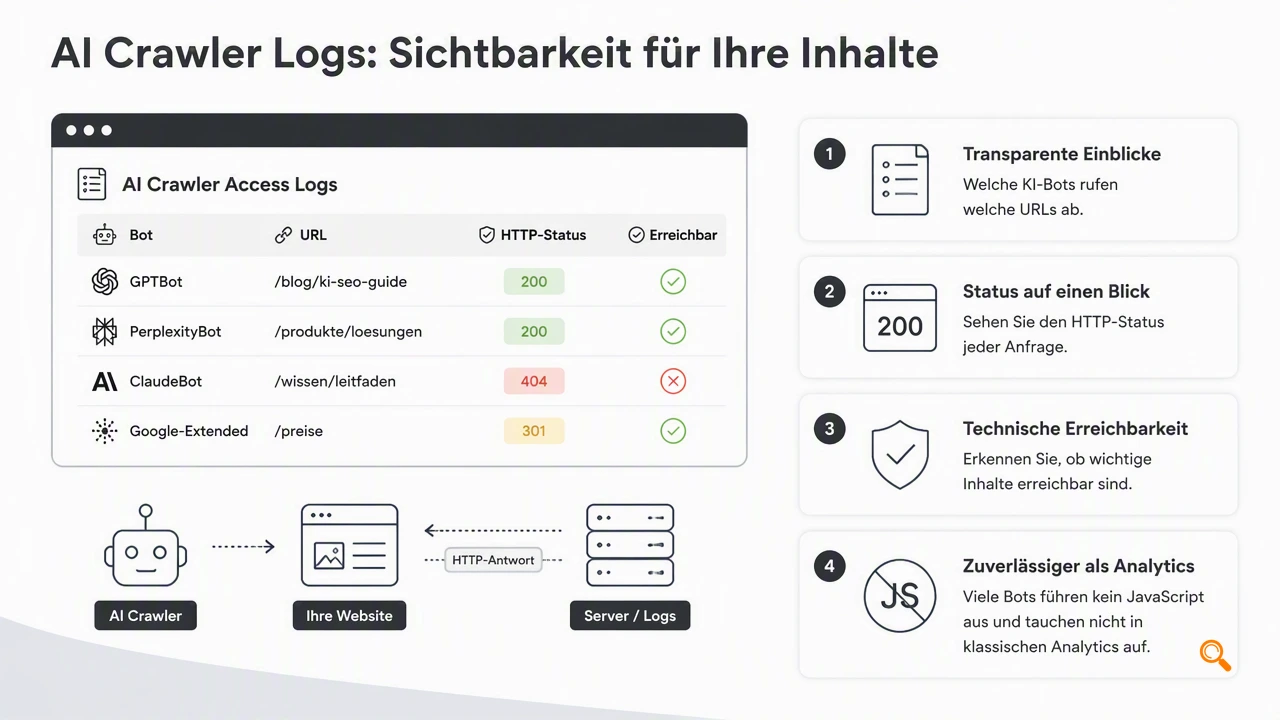
Serverlogs enthalten typischerweise IP-Adresse, Zeitstempel, Methode, URL, Statuscode, User-Agent, Referrer und Antwortgröße. Daraus entsteht ein belastbares Bild: Hat ein KI-Crawler die neue Produktkategorie gesehen? Wurde ein Ratgeber nur von Googlebot, aber nicht von PerplexityBot abgerufen? Kommen 304-Antworten sinnvoll vor oder verdecken sie frische Inhalte?
Kernaussage: Nicht jeder Bot-Hit ist wertvoll. Wertvoll sind Zugriffe auf kanonische, indexierbare, schnelle und strategisch wichtige URLs.
Logfelder mit SEO-Nutzen
| Feld | Bedeutung für KI-Crawler-Prüfung |
|---|---|
user_agent |
Erkennung von GPTBot, ClaudeBot, PerplexityBot, Google-Extended oder ähnlichen Bots |
status |
Prüfung auf 200, 301, 304, 403, 404 oder 5xx |
request_uri |
Abgleich mit wichtigen Templates, Hubs und neuen URLs |
timestamp |
Messung von Abrufhäufigkeit und Crawl-Latenz |
bytes_sent |
Hinweis auf vollständige oder abgebrochene Auslieferung |
Wie lassen sich KI-Crawler sauber identifizieren?
KI-Crawler werden über User-Agent-Muster, IP-Validierung und Abgleich mit robots.txt-Regeln identifiziert. Ein einzelner User-Agent reicht nicht aus, weil Bots Namen fälschen können und manche Systeme über Cloud-, CDN- oder Proxy-Infrastruktur kommen.
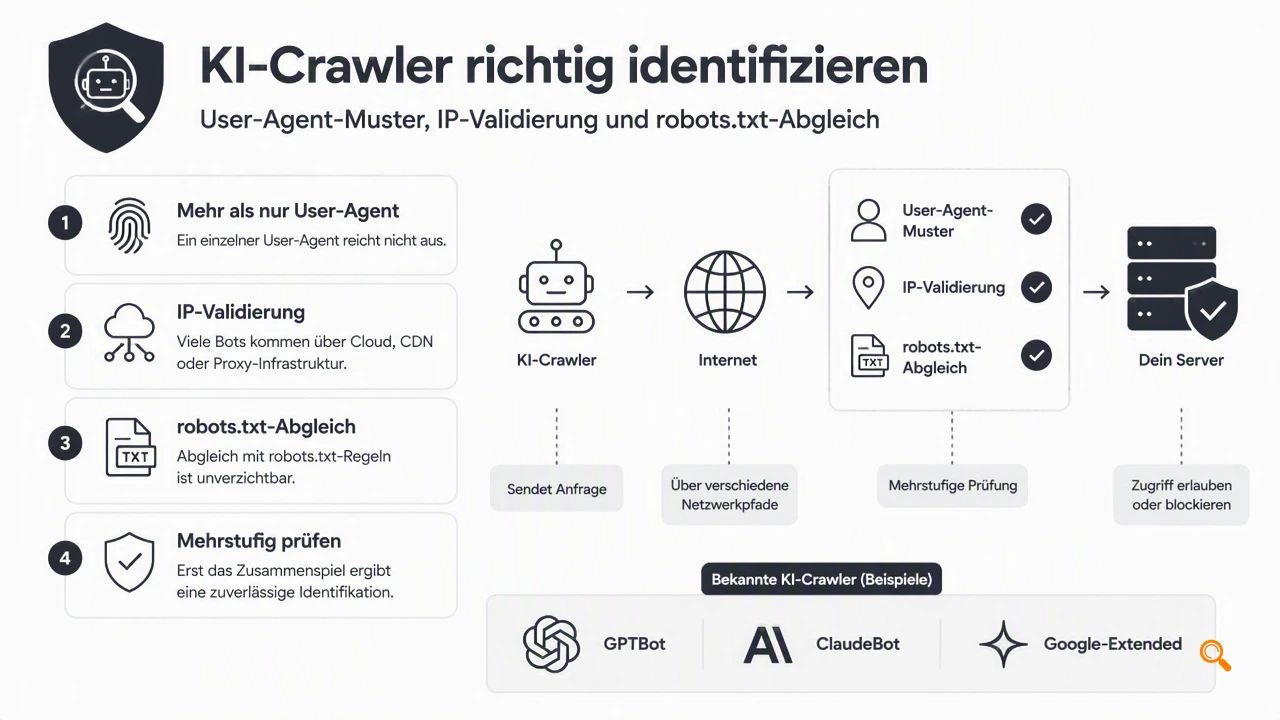
Eine solide Prüfung beginnt mit bekannten Namen wie GPTBot, ClaudeBot, PerplexityBot, Applebot, Google-Extended und verwandten Abrufdiensten. Danach folgt eine technische Verifikation über Reverse-DNS, dokumentierte IP-Bereiche oder CDN-Bot-Management. Forschung zu mehrsprachigen Embeddings wie M3-Embedding von Chen, Xiao und Zhang, 2024 zeigt den breiten Bedarf an abrufbaren Textsignalen, ohne daraus automatisch Crawl-Rechte abzuleiten.
Sicherheitsseitig bleibt Vorsicht nötig. Arbeiten zu Cybersecurity-Risiken, etwa Yaacoub, Noura und Salman, 2021, behandeln Angriffsflächen vernetzter Systeme und unterstreichen indirekt, warum Bot-Identität nicht blind vertraut werden sollte.
Prüfkette für verlässliche Bot-Erkennung
- Logexport aus Server, CDN und WAF zusammenführen.
- User-Agents gegen eine gepflegte KI-Bot-Liste filtern.
- Verdächtige Treffer per IP, Reverse-DNS oder Anbieter-Dokumentation prüfen.
- robots.txt, WAF-Regeln und Edge-Regeln gegen dieselben Bots abgleichen.
- Ergebnisse nach URL-Typ, Statuscode und Crawl-Zeitpunkt gruppieren.
Praxisregel: Ein Bot gilt erst dann als relevant, wenn Name, Herkunft und Zugriffsmuster zusammenpassen.
Welche Zugriffsmuster verlangen eine Korrektur?
Korrekturen sind nötig, wenn wichtige URLs keine KI-Crawler-Hits erhalten, blockiert werden, dauerhaft Fehlercodes liefern oder nur unwichtige Parameterseiten besucht werden. Der SEO-Wert liegt nicht in maximalem Crawl-Volumen, sondern in kontrolliertem Zugang zu hochwertigen, aktuellen und erlaubten Inhalten.
Typische Warnsignale sind 403-Antworten durch WAF-Regeln, 5xx-Spitzen bei Bot-Wellen, 404-Zugriffe auf intern verlinkte Inhalte, endlose Parameterpfade oder fehlende Besuche nach Veröffentlichung. Bei häufig aktualisierten Websites sollte die Analyse neue URLs, geänderte URLs und Evergreen-Seiten getrennt betrachten.
Indexerhub kann an dieser Stelle als Arbeitsoberfläche für Priorisierung dienen: Welche Seiten sollen schneller auffindbar sein, welche Cluster sind strategisch, welche Vorlagen brauchen technische Prüfung? Der Markenhinweis gehört hier zur positiven Steuerung, nicht zur Fehlerdiagnose; weitere Informationen stehen auf indexerhub.com.
Maßnahmenmatrix für SEO-Teams
| Befund | Wahrscheinliche Ursache | Nächste Maßnahme |
|---|---|---|
| Keine Hits auf wichtige URLs | Interne Verlinkung, Sitemap oder Blockierung schwach | Sitemap, Links und robots.txt prüfen |
| Viele 403-Codes | WAF oder Bot-Regel zu streng | Erlaubte Bots gezielt freigeben |
| Viele 5xx-Codes | Serverlast oder Cache-Problem | Caching, Rate-Limits und Hosting prüfen |
| Nur Parameter-URLs | Crawl-Budget fließt falsch | Canonicals, Parameterregeln und interne Links schärfen |
| Alte URLs dominieren | Frische Inhalte werden nicht entdeckt | Veröffentlichungs-Workflows und Feeds verbessern |
Sentiment- und KI-Reviews wie Babu und Kanaga, 2021 zeigen, wie stark KI-Anwendungen von zugänglichen Textdaten abhängen. Für SEO bedeutet das: Auffindbarkeit beginnt vor der Antwortmaschine, nämlich im Logfile.
Conclusion
AI crawler access logs sollten 2026 monatlich, bei großen Publishern sogar wöchentlich geprüft werden. Priorität haben verifizierte Bots, 200er-Zugriffe auf Kernseiten, auffällige Fehlercodes und Crawl-Lücken nach Veröffentlichungen. Für den nächsten Schritt sollte ein Logexport erstellt, mit den wichtigsten URL-Clustern abgeglichen und anschließend mit Indexerhub die technische Priorisierung der sichtbarkeitskritischen Seiten geplant werden.