crawl demand vs crawl capacity: Unterschiede und Diagnose
Crawling-Nachfrage und Serverkapazität unterscheiden: Vergleich, Diagnose und Maßnahmen für große oder häufig aktualisierte Websites.
TL;DR
**Crawl Demand** beschreibt Googles Crawling-Interesse, **Crawl Capacity** die technische Belastbarkeit einer Website. SEO-Teams sollten zuerst Serverdaten und URL-Prioritäten prüfen und anschließend entweder technische Engpässe beheben oder Inhalte und interne Verlinkung verbessern.
Ein schneller Server allein sorgt noch nicht dafür, dass Google wichtige Seiten häufiger besucht. Der Vergleich crawl demand vs crawl capacity trennt technisches Können von Crawling-Interesse und hilft, Maßnahmen für große Websites gezielter auszuwählen. Indexerhub lässt sich als ergänzendes Angebot für den Indexierungsworkflow prüfen; die technische Diagnose liefert dafür die Grundlage.
Table of ContentsWas unterscheidet Crawl Demand von Crawl Capacity?
Crawl Demand: Crawling-Nachfrage beschreibt, wie stark Google Inhalte erneut abrufen möchte. Crawl Capacity: Crawling-Kapazität beschreibt, wie viele Abrufe die Website technisch verträgt. Beide Faktoren wirken zusammen: Freie Serverressourcen erzeugen nicht automatisch Interesse, während stark nachgefragte Inhalte weiterhin eine verlässlich erreichbare Website benötigen. Entscheidend bleibt damit das Zusammenspiel aus Interesse und Belastbarkeit.
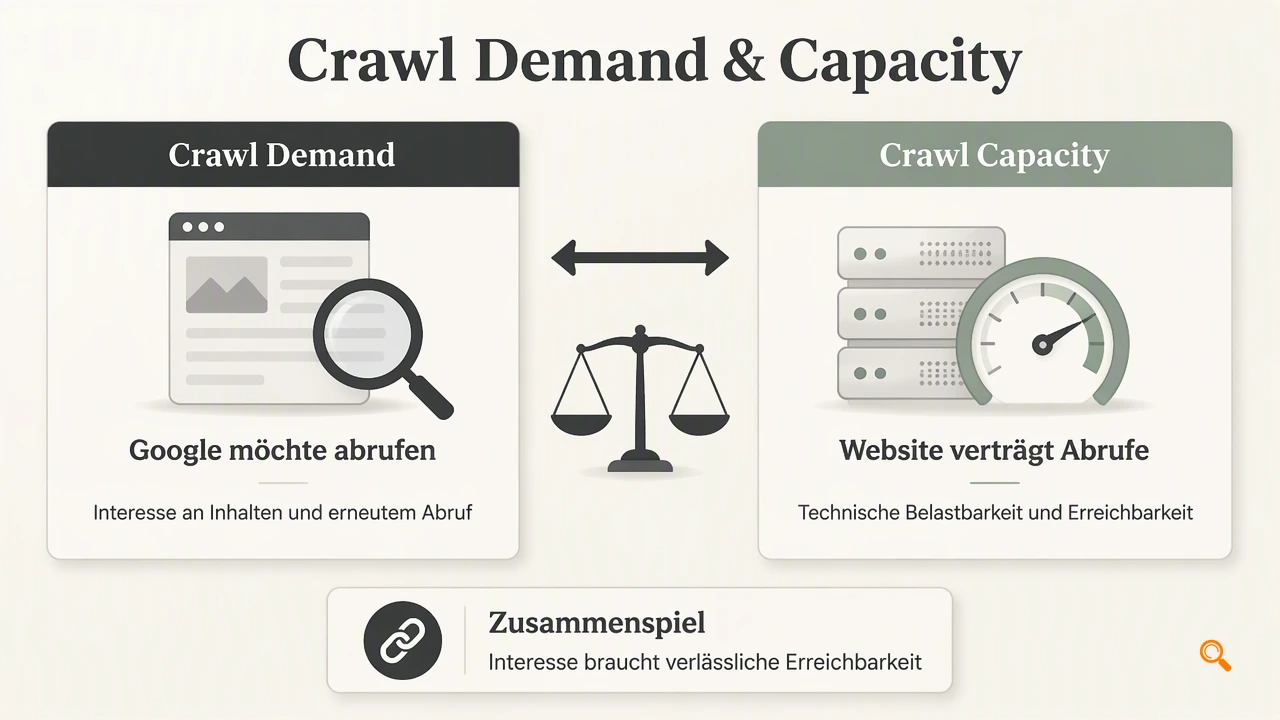
Nachfrage und Kapazität im direkten Vergleich
Der Vergleich ordnet typische Einflussgrößen den beiden Seiten zu.
| Merkmal | Crawl Demand | Crawl Capacity |
|---|---|---|
| Leitfrage | Welche Inhalte möchte Google abrufen? | Welche Abrufe kann die Website bewältigen? |
| Einflussgrößen | Aktualität, Bedeutung und wahrgenommener Inhaltswert | Antwortzeiten, Erreichbarkeit und Serverzustand |
| Interne Links | Machen wichtige URLs auffindbar | Erhöhen nicht unmittelbar die Serverleistung |
| Ansatzpunkt | Nützliche Inhalte und klare Prioritäten | Stabile Infrastruktur und schnelle Antworten |
Der Crawl-Budget-Beitrag von Ricard Menor erläutert ebenfalls die Verbindung zwischen verfügbaren Ressourcen und Googles Crawling-Entscheidungen.
Wie lässt sich der Crawling-Engpass diagnostizieren?
Die Diagnose eines Crawling-Engpasses beginnt mit beobachtbaren Abrufen statt mit Vermutungen über das Crawl-Budget.
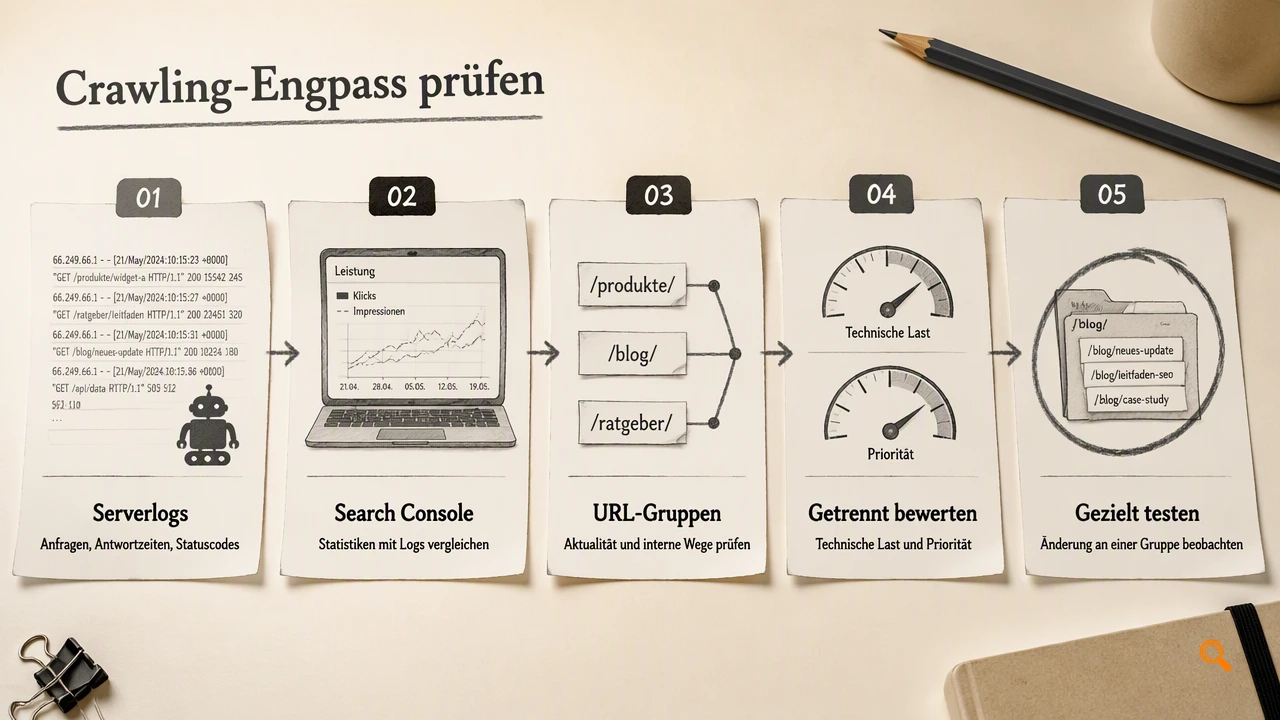
- Serverlogs nach Googlebot-Anfragen, Antwortzeiten und Statuscodes auswerten.
- Crawling-Statistiken der Google Search Console mit diesen Daten vergleichen.
- Wichtige URL-Gruppen nach Aktualität und interner Erreichbarkeit prüfen.
- Technische Belastung und inhaltliche Priorität getrennt bewerten.
- Änderungen zunächst an einer klar abgegrenzten URL-Gruppe beobachten.
Diagnosefragen für große URL-Bestände
Gezielte Fragen helfen, die passende Maßnahme zu wählen.
- Steigen Antwortzeiten während intensiver Abrufe? Dann verdient die Kapazität zuerst Aufmerksamkeit.
- Bleiben wichtige Seiten trotz stabiler Antworten selten besucht? Dann sollten Auffindbarkeit und Inhaltswert geprüft werden.
- Sind Änderungen substanziell oder betreffen sie nur Datumsangaben? Echte Aktualisierungen bieten einen nachvollziehbaren Anlass zum erneuten Crawlen.
Bei Marktplätzen lohnt sich die getrennte Betrachtung von Kategorien, Angeboten und Filterseiten. Durchschnittswerte für die gesamte Domain können Unterschiede zwischen diesen Gruppen verdecken.
Mehr Crawling ist kein Selbstzweck: Entscheidend sind Abrufe relevanter, indexierbarer Seiten.
Häufige Fragen zur Crawling-Priorisierung
Die folgenden Antworten trennen technische Voraussetzungen, inhaltliche Signale und Indexierungsergebnisse.
Erhöht ein schnellerer Server automatisch die Nachfrage?
Ein schnellerer Server verbessert die technische Voraussetzung für Crawling, erzeugt aber nicht automatisch zusätzliche Nachfrage. Bei bereits stabiler Erreichbarkeit sollten SEO-Teams deshalb prüfen, welche Inhalte einen erneuten Abruf rechtfertigen. Die Entscheidung für leistungsfähigeres Hosting sollte auf Antwortzeiten und Belastungsdaten beruhen.
Welche Rolle spielen interne Links und Seitenqualität?
Interne Links machen relevante Seiten auffindbar und verdeutlichen ihre Einordnung innerhalb der Website. Seitenqualität betrifft dagegen den Nutzen des Inhalts selbst. Für umfangreiche Websites empfiehlt sich eine klare Verlinkung wichtiger Kategorien und eigenständiger Detailseiten, ergänzt durch substanzielle statt rein kosmetische Aktualisierungen.
Garantiert häufigeres Crawling eine Indexierung?
Häufigeres Crawling garantiert keine Indexierung, weil Abruf und Aufnahme in den Suchindex unterschiedliche Schritte sind. Nach einem erfolgreichen Abruf müssen SEO-Teams deshalb auch Indexierbarkeit, kanonische Zuordnung und Inhaltswert betrachten. Ein Crawl-Budget-Projekt sollte nicht ausschließlich anhand zusätzlicher Bot-Anfragen bewertet werden, sondern anhand relevanter Ergebnisse.
Conclusion
SEO-Teams sollten jetzt eine wichtige URL-Gruppe auswählen, Serverlogs prüfen und eine passende technische oder inhaltliche Maßnahme testen. Für ergänzende Indexierungsprozesse bietet sich die Prüfung von Indexerhub an. Auf indexerhub.com lassen sich die angebotenen Möglichkeiten mit dem konkreten Bedarf des Teams abgleichen.