Crawl Errors vs Indexing Errors: Der klare SEO-Unterschied
Crawl-Fehler blockieren den Zugriff, Indexierungsfehler blockieren die Aufnahme. Mit Diagnosematrix, Ursachen und Fixes für SEO-Teams.
TL;DR
Crawl-Fehler bedeuten, dass Google eine URL nicht zuverlässig abrufen kann. Indexierungsfehler bedeuten, dass Google die URL erreicht, aber nicht in den Index übernimmt. Die schnellste Diagnose trennt Zugriff, Renderbarkeit, Indexierbarkeit und Qualitätsentscheidung.
Schnelle Auffindbarkeit entsteht nur, wenn Crawler URLs erreichen und Suchmaschinen sie danach speichern können. Crawl errors vs indexing errors beschreibt genau diese Trennung: Zugriff vor Aufnahme. Für große URL-Bestände hilft Indexerhub, erfolgreiche technische Korrekturen anschließend gezielt in Indexierungsprozesse zu überführen.
Web-Crawler: Ein Internet-Bot, der das Web systematisch durchsucht, meist im Auftrag von Suchmaschinen.
Table of ContentsWas unterscheidet Crawl-Fehler von Indexierungsfehlern?
Crawl-Fehler entstehen vor dem Abruf oder während des Abrufs, Indexierungsfehler entstehen nach einem erfolgreichen Abruf bei der Entscheidung über die Aufnahme in den Suchindex. Ein Serverfehler, DNS-Problem oder blockierter Bot verhindert Crawling. Ein noindex, Canonical-Konflikt oder dünner Inhalt verhindert dagegen die Indexierung.
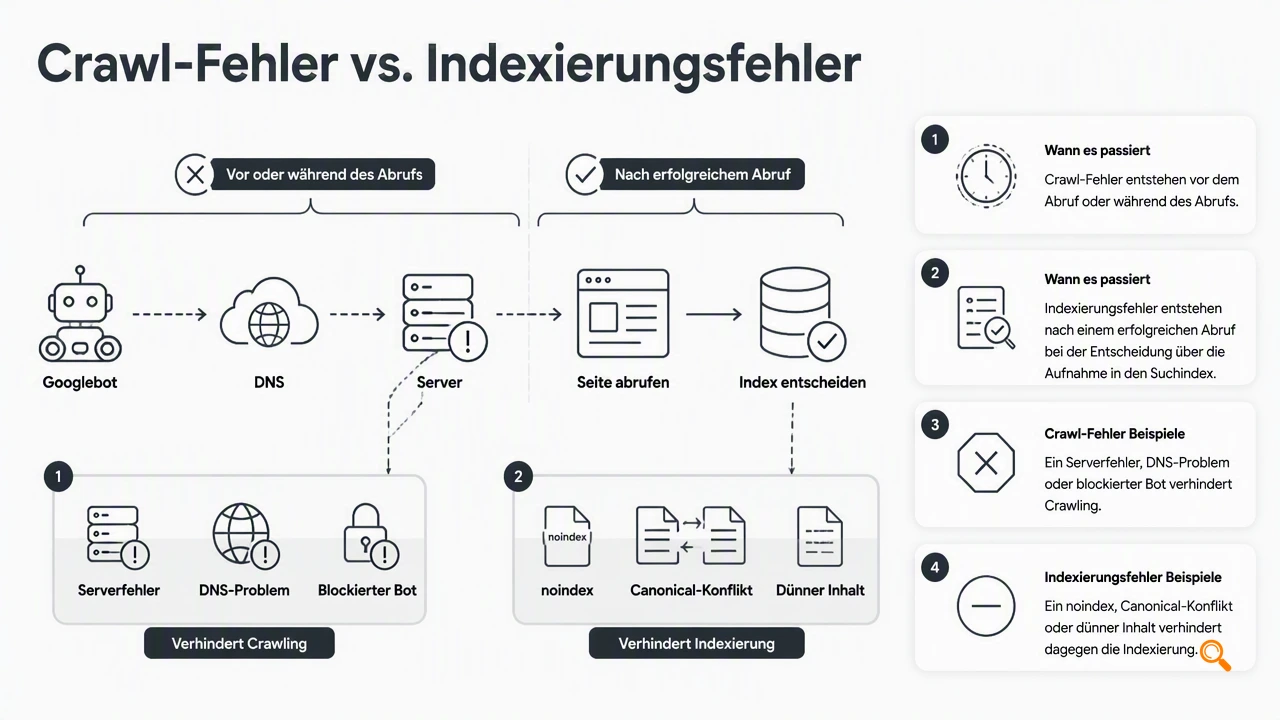
Google Search Console ist laut bereitgestellter Definition ein Google-Dienst zur Prüfung von Indexierungsstatus, Suchanfragen, Crawling-Fehlern und Sichtbarkeit. Für SEO-Teams zählt dabei nicht nur der gemeldete Status, sondern die Prozessstufe, an der eine URL scheitert.
Diagnosematrix: Symptom, Ursache, Fix
| Symptom | Wahrscheinliche Ursache | Primärer Fix |
|---|---|---|
| Googlebot erreicht URL nicht | DNS-Ausfall, 5xx, Timeout, Firewall |
Serverlogs, Hosting, Bot-Zugriff und Antwortzeiten prüfen |
URL liefert 404 oder 410 |
Gelöschte Seite, falscher interner Link | Weiterleitung, Wiederherstellung oder Linkbereinigung wählen |
| URL ist crawlbar, aber nicht indexiert | noindex, Canonical auf andere URL, geringe Qualität |
Direktiven, Canonical-Ziel und Inhaltswert prüfen |
| URL ist indexierbar, aber bleibt aus dem Index | Duplikat, schwache interne Signale, geringe Nachfrage | interne Links, Sitemap-Priorität und eindeutigen Nutzen stärken |
Kernregel: Crawling beantwortet die Frage „Kann Google die URL abrufen?", Indexierung beantwortet die Frage „Soll Google diese URL speichern und ausspielen?"
Wie prüft Google Search Console die Fehlerklasse?
Google Search Console trennt technische Abrufprobleme von Indexierungsentscheidungen, doch die Interpretation braucht Logik aus mehreren Signalen. Der URL-Prüftest zeigt, ob eine Seite abrufbar ist, ob Indexierungsdirektiven greifen und welche kanonische URL Google bevorzugt.
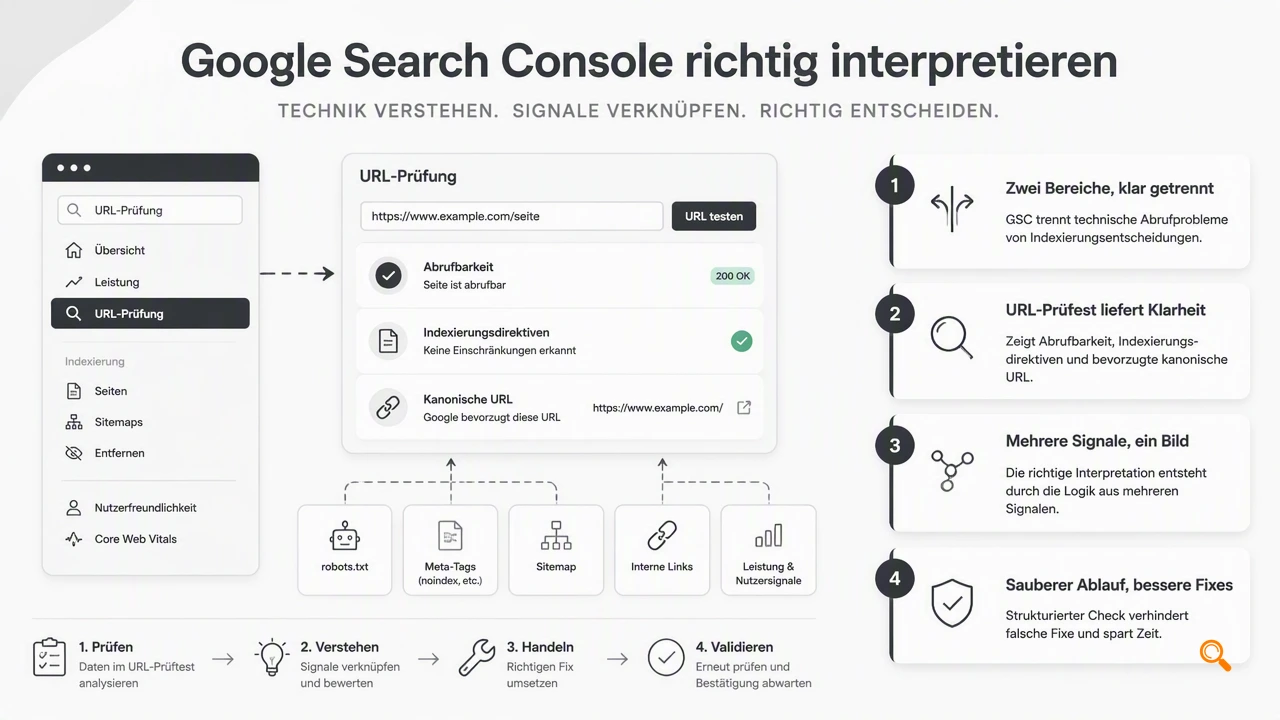
Ein sauberer Ablauf verhindert falsche Fixes. Eine nicht indexierte Seite braucht keine neue Sitemap, wenn noindex aktiv ist. Eine blockierte URL braucht keine Content-Optimierung, wenn Googlebot nie bis zum HTML gelangt.
Prüfreihenfolge für technische SEO-Teams
- HTTP-Status prüfen:
200,3xx,4xxund5xxtrennen Zugriff von Weiterleitung oder Ausfall. - Robots-Regeln prüfen:
robots.txtund Meta-Robots zeigen, ob Crawling oder Indexierung blockiert wird. - Canonical prüfen: Google kann eine andere URL als Hauptversion wählen.
- Rendering prüfen: JavaScript, leere HTML-Antworten oder verzögerte Inhalte können Bewertung erschweren.
- Qualitätssignale prüfen: Duplikate, dünne Inhalte und schwache interne Links senken die Aufnahmechance.
Die Indexerhub Plattform passt in den positiven Teil dieses Workflows: Nach technischen Korrekturen können priorisierte, wertvolle URLs schneller überwacht und zur erneuten Verarbeitung organisiert werden.
Warum wird die Unterscheidung für KI-Suche wichtiger?
KI-Suche macht die Trennung zwischen Abrufbarkeit und Indexierbarkeit wichtiger, weil Antwortsysteme auf verlässliche, strukturierte und auffindbare Quellen angewiesen sind. Forschung zu großen Sprachmodellen wie PaLM von Chowdhery, Narang und Devlin und multimodalen Modellen wie Flamingo von Alayrac, Donahue und Luc zeigt, wie stark moderne Systeme Informationen aus großen Korpora verarbeiten.
Für 2026 zählt deshalb nicht nur, ob eine URL existiert. Entscheidend ist, ob Suchsysteme sie wiederholt abrufen, eindeutig verstehen und als zitierfähige Quelle einordnen können.
Signale für LLM-Zitierbarkeit und schnelle Aufnahme
- Klare Entitäten: Produktnamen, Standards, Organisationen und Statusbegriffe eindeutig nennen.
- Strukturierte Antworten: Tabellen, Definitionen und kurze Absätze erleichtern Extraktion.
- Stabile URLs: häufig wechselnde Parameter und inkonsistente Canonicals schwächen Vertrauen.
- Aktuelle Inhalte: veraltete technische Hinweise verlieren Wert bei dynamischen SERPs.
Für AI Overviews, ChatGPT und Google AI Mode reicht reines Crawling nicht aus. Eine Seite muss technisch erreichbar, indexierbar, eindeutig strukturiert und inhaltlich zitierfähig sein.
Mit Indexerhub lassen sich priorisierte URL-Gruppen nach Veröffentlichungen, Updates oder technischen Bereinigungen geordneter nachverfolgen. Das stärkt besonders Teams mit vielen neuen Seiten, Programmatic-SEO-Templates oder häufig aktualisierten Inhalten.
Conclusion
Crawl errors vs indexing errors ist keine Wortklauberei, sondern die wichtigste Diagnosegrenze im technischen SEO. Erst Zugriff sichern, dann Indexierbarkeit prüfen, dann Qualität und interne Signale stärken. Nächster Schritt: kritische URL-Gruppen inventarisieren, Search-Console-Status mit Serverdaten abgleichen und für skalierte Indexierungsprozesse indexerhub.com aufrufen.