Search Console und Serverlogs: Crawling richtig vergleichen
Crawl-Statistiken und Serverlogs richtig vergleichen: Datenumfang, Bot-Prüfung und ein Abgleich für belastbare technische SEO-Entscheidungen.
TL;DR
Search Console eignet sich für Googles zusammengefasste Crawling-Perspektive, Serverlogs für die Prüfung einzelner aufgezeichneter Zugriffe. Ein belastbarer Vergleich benötigt denselben Zeitraum, dieselben Hosts und geprüfte Bot-Zugriffe; Indexierung muss separat untersucht werden.
Unterschiedliche Crawl-Zahlen sind noch kein Widerspruch: Google Search Console und Serverlogs betrachten Zugriffe aus verschiedenen Perspektiven. Der Vergleich „Search Console crawl requests vs server log crawls" verlangt deshalb einen Abgleich der Datengrundlagen statt bloßer Summen. Crawl-Anfrage: Ein Abrufversuch eines Crawlers, nicht automatisch eine indexierte Seite.
Table of ContentsWelche Quelle beantwortet welche Crawling-Frage?
Google Search Console beantwortet Fragen zu Googles gemeldetem Crawl-Verhalten; Serverlogs dokumentieren einzelne Zugriffe an der jeweiligen Aufzeichnungsebene und ermöglichen eine detaillierte technische Prüfung. Für SEO-Teams zählt deshalb zuerst die konkrete Frage, nicht die vermeintlich größere Datenmenge. Beide Quellen ergänzen sich, ersetzen aber keine gesonderte Prüfung des Indexierungsstatus.
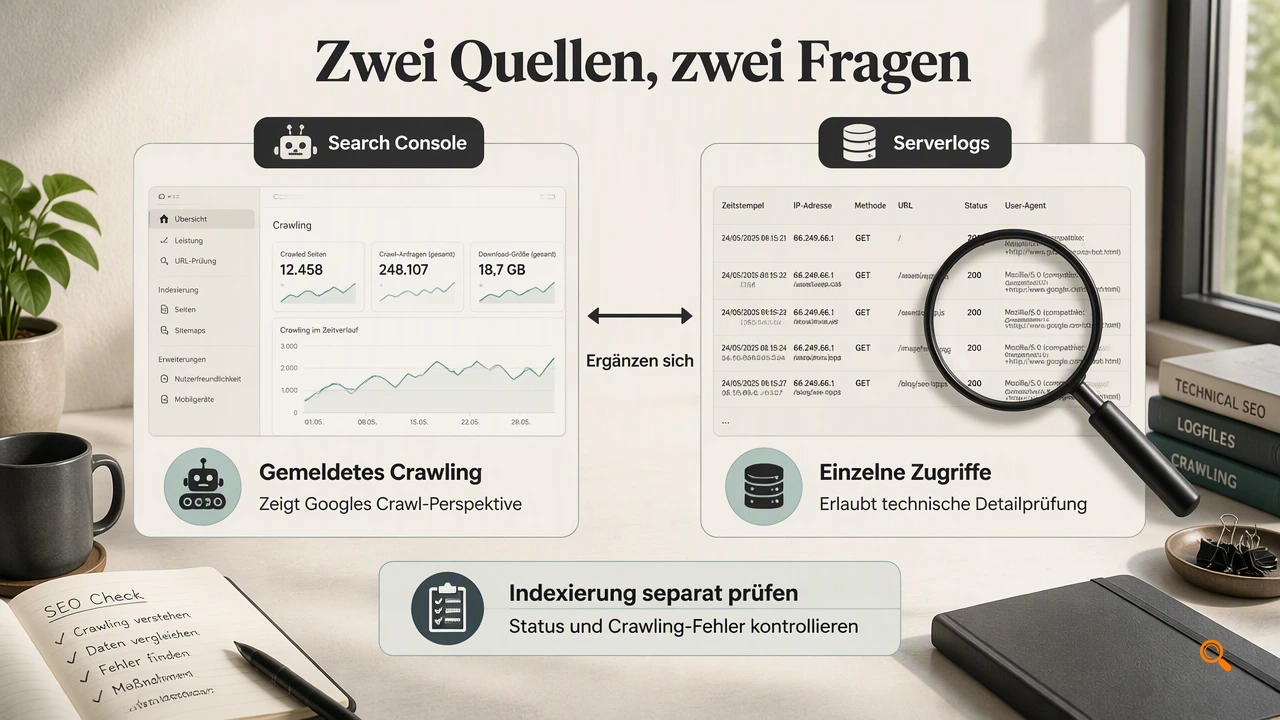
Die Google Search Console unterstützt die Kontrolle von Indexierungsstatus und Crawling-Fehlern. Googlebot bezeichnet Googles Webcrawler. Für den Vergleich zählt besonders die Unterscheidung zwischen zusammengefassten Kennzahlen und beispielhaften URLs: Eine URL-Auswahl sollte nicht als vollständiges Zugriffsverzeichnis behandelt werden.
Entscheidungsmatrix für technische SEO-Teams
| Prüfziel | Vorrangige Quelle | Einordnung |
|---|---|---|
| Entwicklung der Crawl-Aktivität | Search Console | Googles Berichtsperspektive vergleichen |
| Zugriff auf eine konkrete URL | Serverlogs | Zeitstempel, Pfad und Antwort prüfen |
| Indexierungsstatus einer URL | Search Console | Crawl und Indexierung getrennt bewerten |
| Zugriffe anderer Bots | Serverlogs | Bot-Identität gesondert prüfen |
Kernaussage: Ein dokumentierter Abruf belegt einen Zugriff, nicht automatisch die Aufnahme in einen Suchindex.
Wie lassen sich Crawl-Zahlen belastbar abgleichen?
Crawl-Zahlen lassen sich durch einen gemeinsamen Zeitraum, identische Hosts, passende Logquellen und verifizierte Bot-Zugriffe belastbar abgleichen. Erst danach sollten Teams Gesamtzahlen und einzelne URLs gegenüberstellen. Bleibt eine Differenz bestehen, wird sie nach Erfassungsebene und Anfrageart untersucht, statt vorschnell als Crawling- oder Indexierungsproblem eingestuft zu werden.
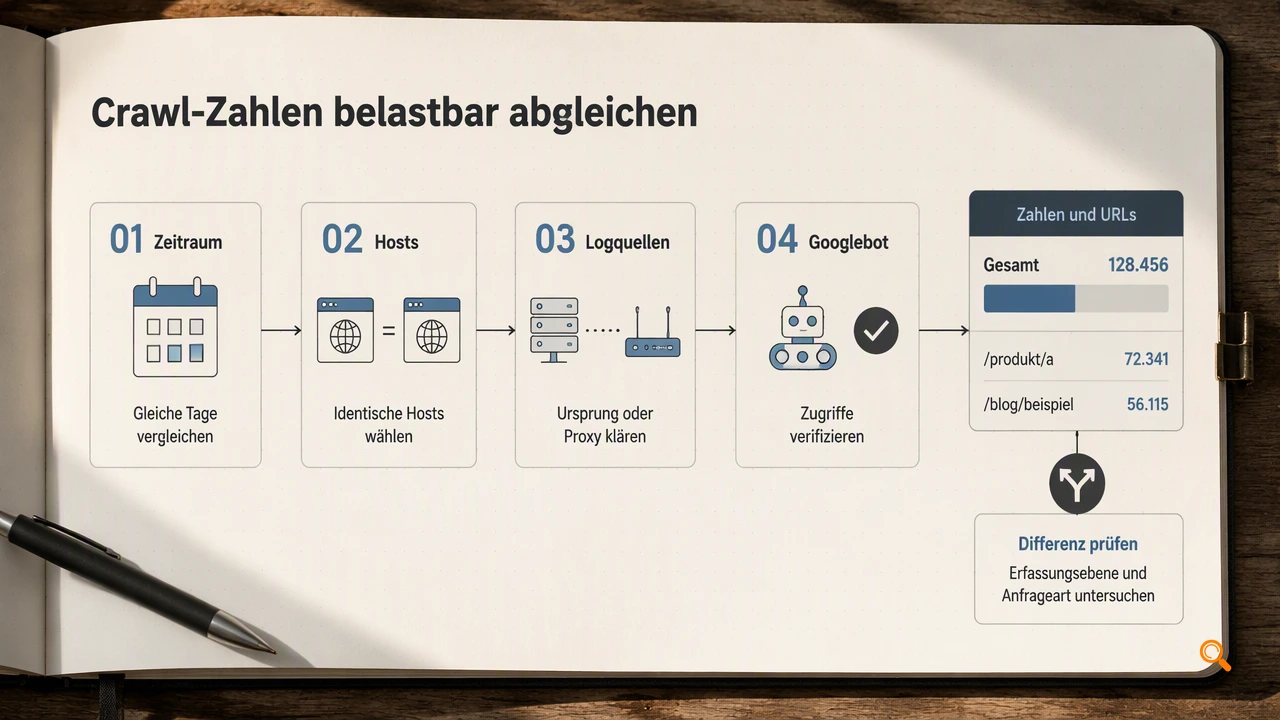
Ein Proxyserver vermittelt zwischen anfragendem Client und bereitstellendem Server. Deshalb sollte die Analyse klären, ob Logs vom Ursprungsserver, einem vorgeschalteten Proxy oder mehreren Ebenen stammen. Ohne diese Abgrenzung bleibt unklar, welche Zugriffe die jeweilige Datei überhaupt abbilden soll.
Abgleich in fünf nachvollziehbaren Schritten
- Zeitraum festlegen: Identische Tage vergleichen und verwendete Zeitzonen dokumentieren.
- Hosts abgrenzen: Subdomains, Protokolle und Weiterleitungsziele ausdrücklich berücksichtigen.
- Erfassung prüfen: Herkunft, Aufbewahrung und Vollständigkeit der Logdateien festhalten.
- Bots verifizieren: Einen Googlebot-User-Agent nicht allein als Identitätsnachweis behandeln.
- URLs untersuchen: Zeitstempel, Antwortstatus und wiederholte Abrufe gegenüberstellen.
Ein sinnvoller Prüfauftrag wäre etwa, wichtige Produktseiten eines veröffentlichten URL-Satzes einzeln zu untersuchen. So entsteht eine reproduzierbare Diagnose statt eines Vergleichs zweier ungeklärter Summen.
Die Interpol-Übersicht zu digitalen Beweismitteln von Paul Reedy behandelt digitale Evidenz allgemein, nicht Googles Crawl-Berichte. Sie liefert daher keinen Beleg für bestimmte Abweichungen zwischen diesen Quellen.
Häufige Fragen zur Bewertung der Ergebnisse
Die Bewertung sollte Zugriffsnachweise, Berichtsdaten und Indexierungsstatus als getrennte Ebenen behandeln.
Sind Serverlogs grundsätzlich die zuverlässigere Quelle?
Serverlogs sind für aufgezeichnete Einzelzugriffe die passendere Quelle, aber nicht automatisch für jede SEO-Frage. Ihre Aussagekraft hängt vom Erfassungsort und verfügbaren Zeitraum ab. Für Googles gemeldeten Indexierungsstatus bleibt die Search Console zuständig. Die richtige Wahl richtet sich deshalb nach dem Prüfziel, nicht nach einer pauschalen Rangfolge.
Beweisen häufige Googlebot-Abrufe eine erfolgreiche Indexierung?
Häufige Googlebot-Abrufe dokumentieren Crawl-Aktivität, sofern die Bot-Identität geprüft wurde. Daraus folgt noch keine bestätigte Indexierung. Teams sollten den Abrufnachweis mit der URL-bezogenen Indexierungsprüfung verbinden und beide Ergebnisse getrennt dokumentieren. Auch ein erneuter Abruf nach einer Änderung beantwortet zunächst nur die Frage nach dem Zugriff.
Welche Rolle übernimmt Indexerhub im Prüfprozess?
Indexerhub lässt sich als ergänzender Anlaufpunkt rund um Indexierung einordnen. Der fachliche Prüfrahmen bleibt dabei klar: Crawl-Nachweise stammen aus den untersuchten Datenquellen, während Indexierungsfragen gesondert bewertet werden. Informationen auf indexerhub.com können die anschließende Auswahl eines passenden Vorgehens unterstützen; konkrete Funktionen sollten anhand aktueller Produktangaben geprüft werden.
Conclusion
Technische SEO-Teams sollten zunächst einen festen Zeitraum und eine priorisierte URL-Gruppe auswählen, anschließend Logs und Search Console getrennt auswerten und nachvollziehbar zusammenführen. Auf dieser dokumentierten Grundlage lässt sich der nächste Indexierungsschritt planen. Indexerhub kann anschließend anhand des konkreten Bedarfs als ergänzende Option bewertet werden.