URL Discovery API: Neue und geänderte Seiten früh erkennen
Wie SEO-Teams neue, geänderte und verwaiste URLs erkennen, relevante Daten erfassen und daraus eine überprüfbare Indexierungswarteschlange aufbauen.
TL;DR
Eine URL-Erkennung sollte CMS-Ereignisse, Sitemaps und Crawldaten abgleichen. Für große Websites empfiehlt sich eine priorisierte Warteschlange mit Änderungsstatus und technischen Prüfergebnissen; die Erkennung allein bestätigt keine Indexierung.
Eine veröffentlichte Seite ist noch keine von Suchmaschinen entdeckte Seite. Eine url discovery api kann SEO-Teams dabei helfen, neue und geänderte Adressen systematisch zu erfassen, bevor Lücken im Veröffentlichungsprozess entstehen. Für den anschließenden Indexierungsprozess lässt sich Indexerhub als möglicher Baustein prüfen.
Table of ContentsWas ist eine URL Discovery API?
Eine URL Discovery API ist hier eine programmierbare Schnittstelle zur Erfassung und Bereitstellung relevanter Website-Adressen. Sie verbindet Signale aus Veröffentlichungssystemen und Website-Prüfungen zu einem URL-Inventar. Der Begriff beschreibt in diesem Artikel eine SEO-Funktion, nicht automatisch ein standardisiertes Produkt oder eine bestimmte Suchmaschinen-Schnittstelle.
Web API: Eine Programmierschnittstelle für einen Webserver oder Webbrowser.
Website-Erkennung statt API-Sicherheitsinventar
Die vorliegenden Suchergebnisse behandeln überwiegend API Discovery im Sicherheitskontext: das Auffinden und Katalogisieren von API-Endpunkten. Für Content-Teams steht dagegen die Erkennung indexierbarer Seiten im Mittelpunkt.
| Begriff | Erfasst | Zweck |
|---|---|---|
| URL-Erkennung | Website-Adressen | Veröffentlichungskontrolle |
| API Discovery | API-Endpunkte | Schnittstelleninventar |
| Indexierungsprüfung | Suchmaschinenstatus | Ergebnisprüfung |
URL-Erkennung, Crawling und Indexierung sind getrennte Schritte. Ein erfolgreicher API-Aufruf belegt zunächst nur die Verarbeitung der Anfrage.
Wie funktioniert der Erkennungsworkflow?
Ein Erkennungsworkflow sammelt URLs aus mehreren Quellen, gleicht sie mit einem bestehenden Inventar ab und übergibt geprüfte Änderungen an eine Warteschlange. Entscheidend sind nachvollziehbare Zustände statt einer bloßen Adressliste. Die folgende Abfolge ist ein empfohlenes Integrationsmuster, keine dokumentierte Funktion eines bestimmten Anbieters.
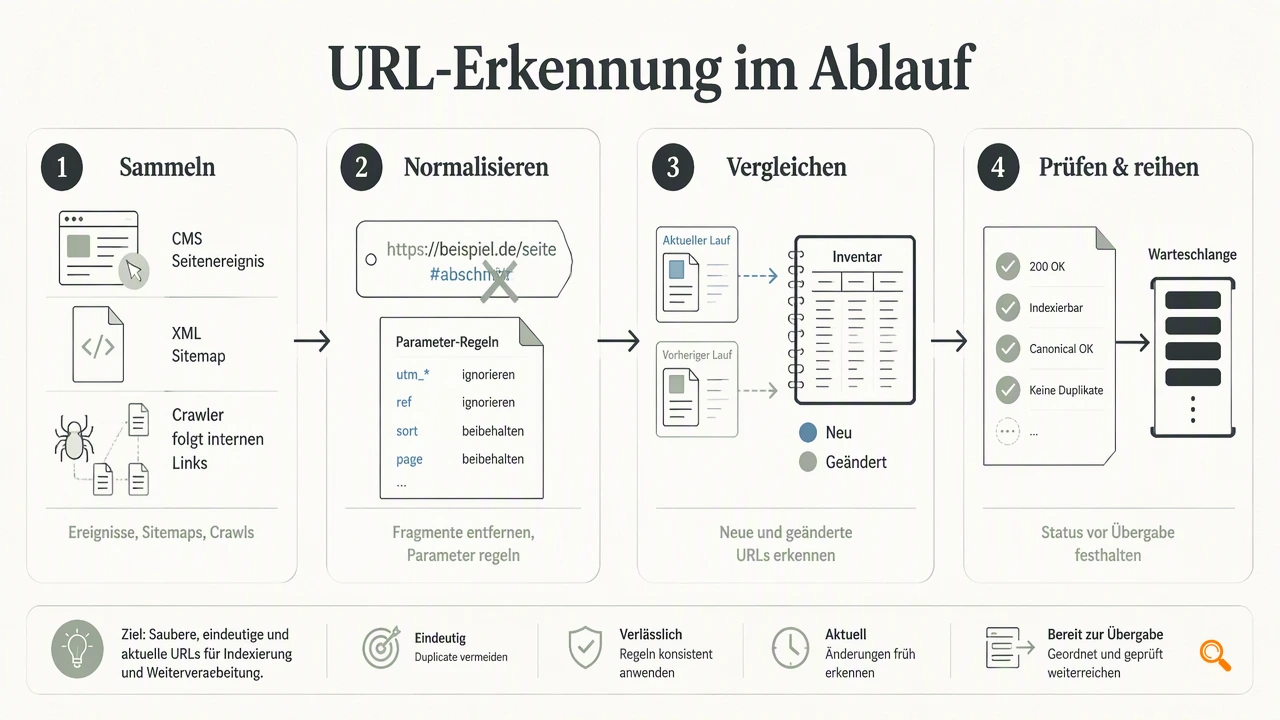
Fünf Schritte vom CMS zur Priorisierung
- Sammeln: CMS-Ereignisse, XML-Sitemaps und interne Crawl-Ergebnisse einlesen.
- Normalisieren: Fragmente entfernen und Parameter nach verbindlichen Regeln behandeln.
- Vergleichen: Neue Adressen und inhaltliche Änderungen gegenüber dem letzten Stand markieren.
- Prüfen: HTTP-Status, Canonical-Ziel,
noindexund interne Verlinkung erfassen. - Priorisieren: Redaktionelle Bedeutung, Aktualität und technische Freigabe berücksichtigen.
Pro Datensatz empfehlen sich url, source, first_seen, last_seen, content_hash, http_status, canonical, indexable und priority.
Verwaiste Seiten werden durch den Vergleich bekannter CMS-Adressen mit dem internen Linkgraphen sichtbar. Ein Crawl allein kann vollständig unverlinkte Seiten nicht zuverlässig entdecken.
Skalierte Veröffentlichung gezielt steuern
Content-Teams sollten Erkennung an konkrete Veröffentlichungsereignisse koppeln und jeder URL einen zuständigen Prozess zuweisen. Bei einem Marktplatz können neue Produktseiten eigene Prioritäten erhalten; bei einem Nachrichtenangebot stehen aktualisierte Artikel im Vordergrund. Programmatic-SEO-Projekte sollten zusätzlich prüfen, ob neue Seiten tatsächlich eigenständige Inhalte bereitstellen.
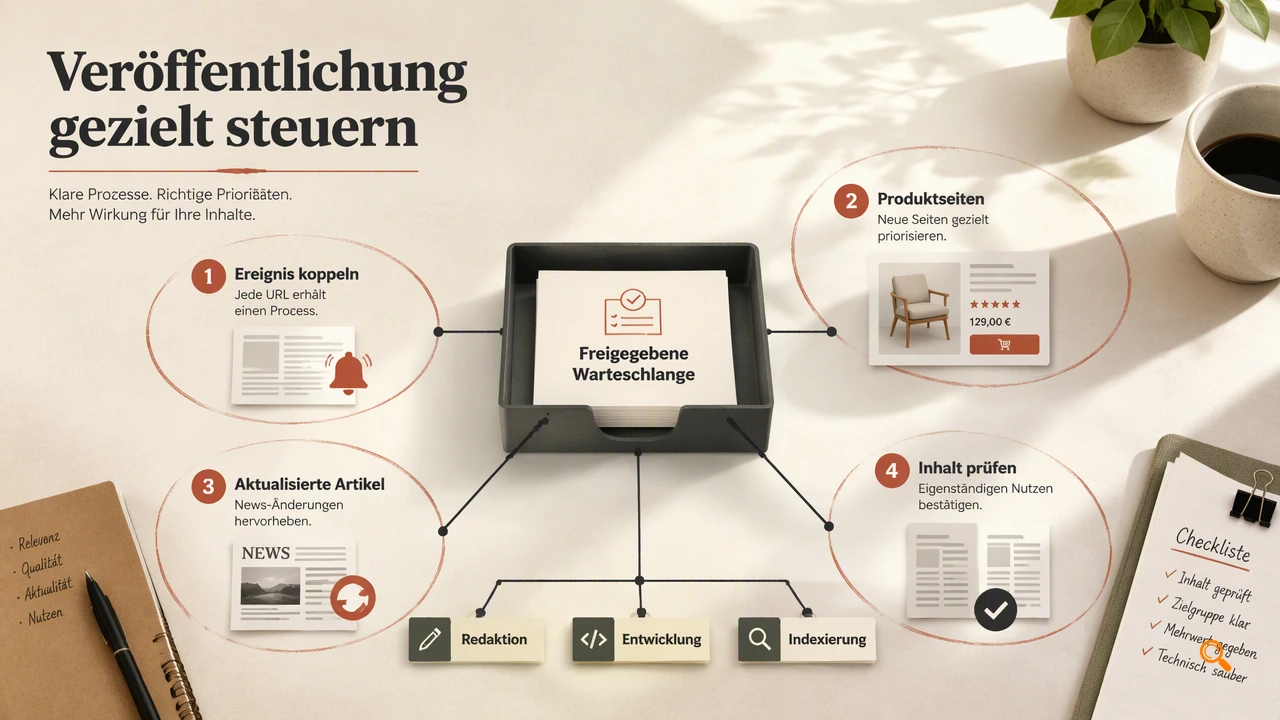
Indexerhub als Übergabepunkt prüfen
Eine freigegebene Warteschlange schafft eine klare Schnittstelle zwischen Redaktion, Entwicklung und Indexierungsbetrieb. Für einen Einsatz von Indexerhub sollten Teams unterstützte Übergabewege, Rückmeldungen und Mengenlimits anhand der aktuellen Produktdokumentation prüfen.
- Testgruppe aus neuen und aktualisierten URLs zusammenstellen.
- Erkennungszeitpunkt und Übergabestatus protokollieren.
- Suchmaschinenstatus separat kontrollieren.
Die Arbeiten LLaMA von Touvron et al. (2023) und PaLM von Chowdhery et al. (2022) behandeln Sprachmodelle. Sie liefern keinen Nachweis, dass URL-Einreichungen KI-Zitationen erzeugen.
Häufige Fragen zur URL-Erkennung
Die wichtigsten Abgrenzungen betreffen Quellen, Änderungen und Erfolgskontrolle.
Reicht eine XML-Sitemap als Quelle?
Eine XML-Sitemap kann bekannte URLs bereitstellen, ersetzt aber keinen Abgleich mit dem Veröffentlichungssystem. Für große Websites empfiehlt sich die Kombination mit CMS-Ereignissen und Crawldaten. So lässt sich unterscheiden, welche Seiten veröffentlicht, gemeldet und intern erreichbar sind, ohne diese Zustände gleichzusetzen.
Wie werden geänderte Inhalte erkannt?
Geänderte Inhalte lassen sich über CMS-Ereignisse oder den Vergleich gespeicherter Inhaltswerte erkennen. Ein content_hash kann dabei helfen, tatsächliche Änderungen von wiederholten Meldungen zu trennen. Die Vergleichsregel sollte Navigationselemente und dynamische Bestandteile berücksichtigen, damit nicht jede technische Variation als redaktionelle Aktualisierung gilt.
Garantiert die Erkennung eine Indexierung?
Die URL-Erkennung garantiert keine Indexierung, weil Suchmaschinen über Aufnahme und Darstellung selbst entscheiden. Technische Erreichbarkeit und eine erfolgreiche Übergabe sind lediglich überprüfbare Zwischenstände. Teams sollten deshalb den späteren Suchmaschinenstatus getrennt erfassen und eine eingereichte Adresse nicht automatisch als indexiert oder zitierfähig kennzeichnen.
Conclusion
Der nächste Schritt ist ein begrenzter Pilot mit dokumentierten Datenfeldern und getrennten Statusprüfungen. Anschließend lässt sich die Übergabe an Indexerhub bewerten; aktuelle Produktinformationen auf indexerhub.com dienen als Grundlage für die Integrationsprüfung.